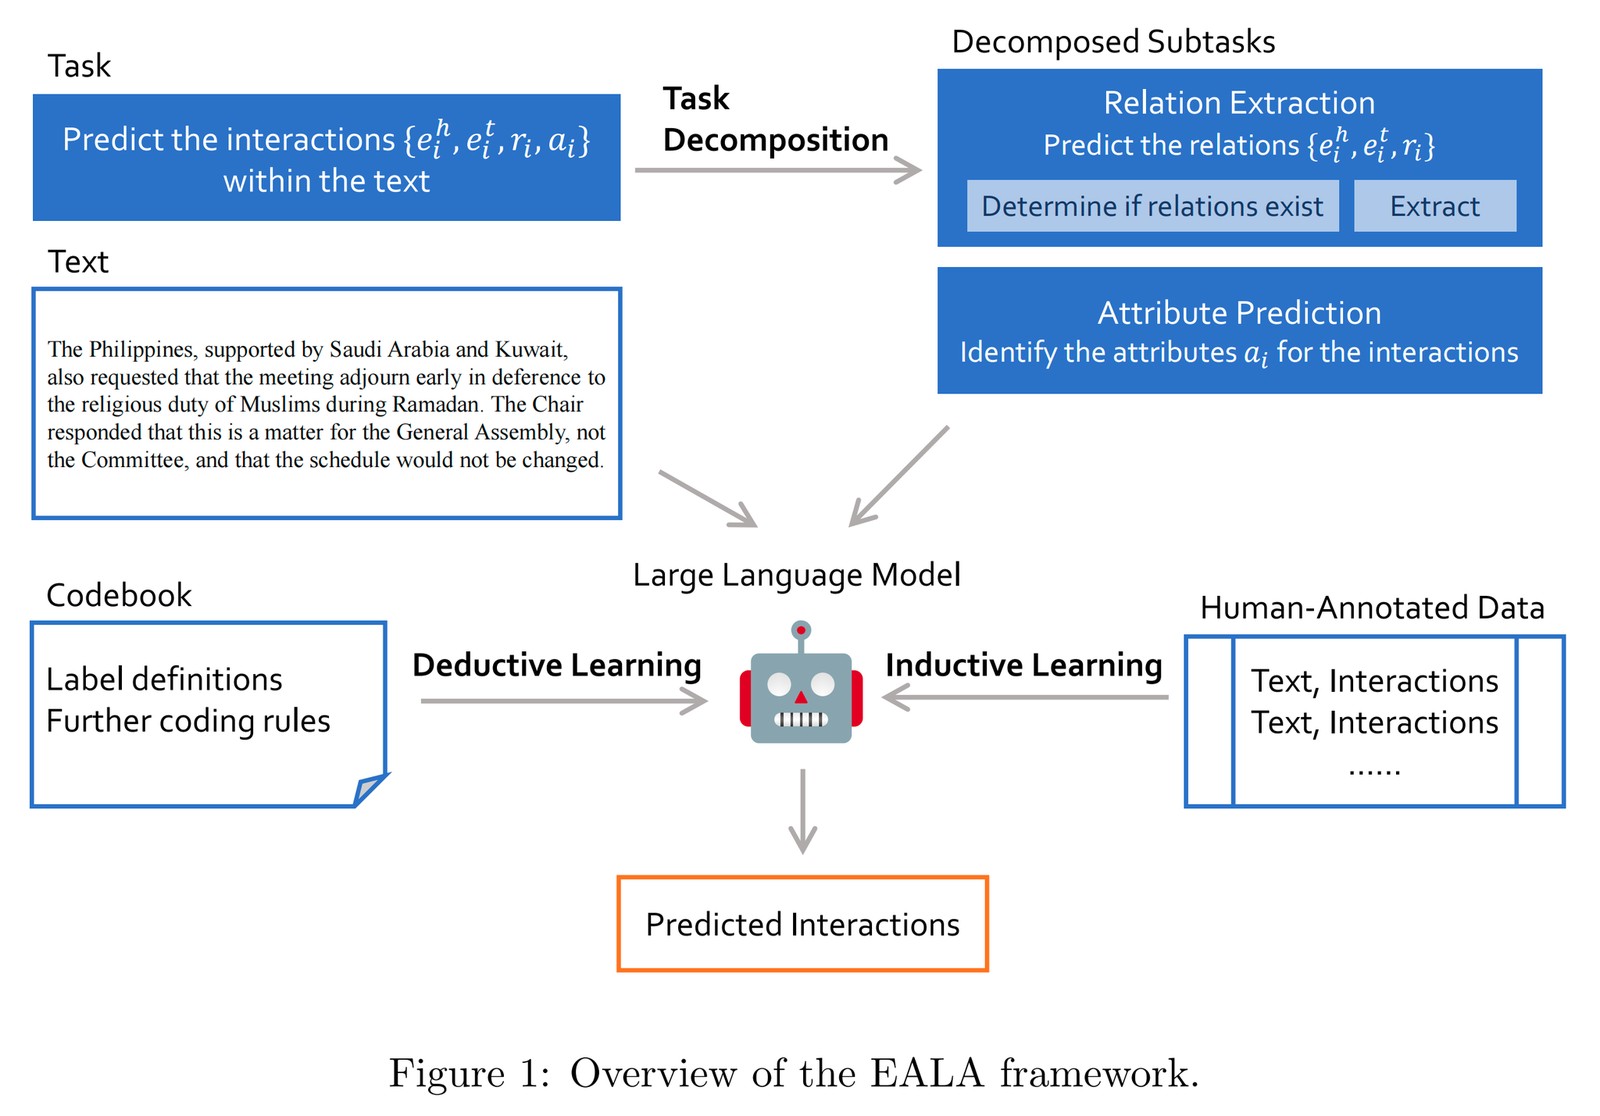
01 / 为什么这个项目首先是一个「测量问题」
国际气候谈判数据库过去长期依靠研究人员人工阅读和标注。这种方式质量高,但更新慢、成本高,而且不同标注者之间也会产生判断差异。
项目希望使用 LLM 接续这部分数据生产。但这里有一个很容易被忽略的问题:
如果我们只拿模型结果和某一个人工标注员比较,那么即使最后得到一个 Precision 或 Recall,也很难回答——模型到底是真的错了,还是人工自己就存在分歧?
所以在评估模型之前,我们首先需要建立一套足够可靠的人工参照。这是我在项目中主要负责的部分。
02 / Human Baseline 怎么建立
我组织了 10 名评测员参与人工标注。对于复杂的国际谈判关系,仅仅发一份任务说明远远不够——很多概念在研究上可以讨论,但到了数据生产阶段必须能够被不同的人稳定执行。
因此评测流程围绕 Codebook 展开:每一个关系类型都需要被进一步写成明确的判断规则,并通过案例解释边界。
正式标注时,每段材料由两名评测员独立完成——两个人在看到对方答案之前不能互相讨论,避免第二个人被第一人的判断影响。完成以后,再把不一致的项目集中拿出来讨论和仲裁。
最后得到的不是「某一个人认为正确的答案」,而是一套经过一致性验证的人工基准。
03 / 模型到底有没有达到人工水平
10 名评测员最终完成了 153 个谈判段落的双人独立关系标注。基于 Human Baseline 进行比较后:
- EALA 在复杂关系抽取任务中的 Precision 达到 74.0%,高于单人标注基线的 67.5%;
- Recall 达到 90.0%,与人工基线的 89.2% 基本持平。
这组结果真正有意义的地方,不是简单地说「模型超过了人」。它证明的是:
在这项特定的数据生产任务上,经过专家知识增强和质量控制的 LLM 系统, 已经能够达到与人工标注相当的可靠性,并在 Precision 上超过单个标注者。 这是系统进一步扩大数据生产规模的前提。
04 / 除了测模型,还要检查模型生产的数据
模型通过基准测试以后,工作并没有结束。
在动态议题空间生成过程中,我参与人工审读模型生成的议题名称和描述,最终有 27.8% 的议题描述经过人工修订。这说明一个模型即使在关系抽取任务上表现不错,也不意味着它在所有后续任务上都可以直接无人值守。
针对议题预测,我们又另外建立了一套覆盖 50 个段落、394 条互动关系的专项评测集,继续采用双人独立标注与分歧讨论后,标注一致性达到 0.79。
05 / 这段经历后来怎么影响我做产品
最终,EALA 被用于 678 份国际气候谈判日报,自动生成 45,051 条互动数据, 并把数据库更新到 2024 年;合作论文入选 2025 Asian PolMeth Conference。
但对我后来做 AI 产品影响最大的,并不是这些数字。而是我第一次完整经历了:
先定义什么叫「正确」,再评价模型做得怎么样。
后来做全球商业洞察 Agent 和知香时,我仍然沿用了这个习惯——先做评测集、明确硬门禁,再开始比较不同 Prompt、Agent 或检索方案。
如果重新做这个项目,我会让评测员更早参与 Codebook 的修改。最初规则主要由上游制定、再由评测员执行,很多真正模糊的边界直到标注过程中才暴露出来;后来我们逐渐让一线评测员参与规则讨论以后,对齐明显更快。