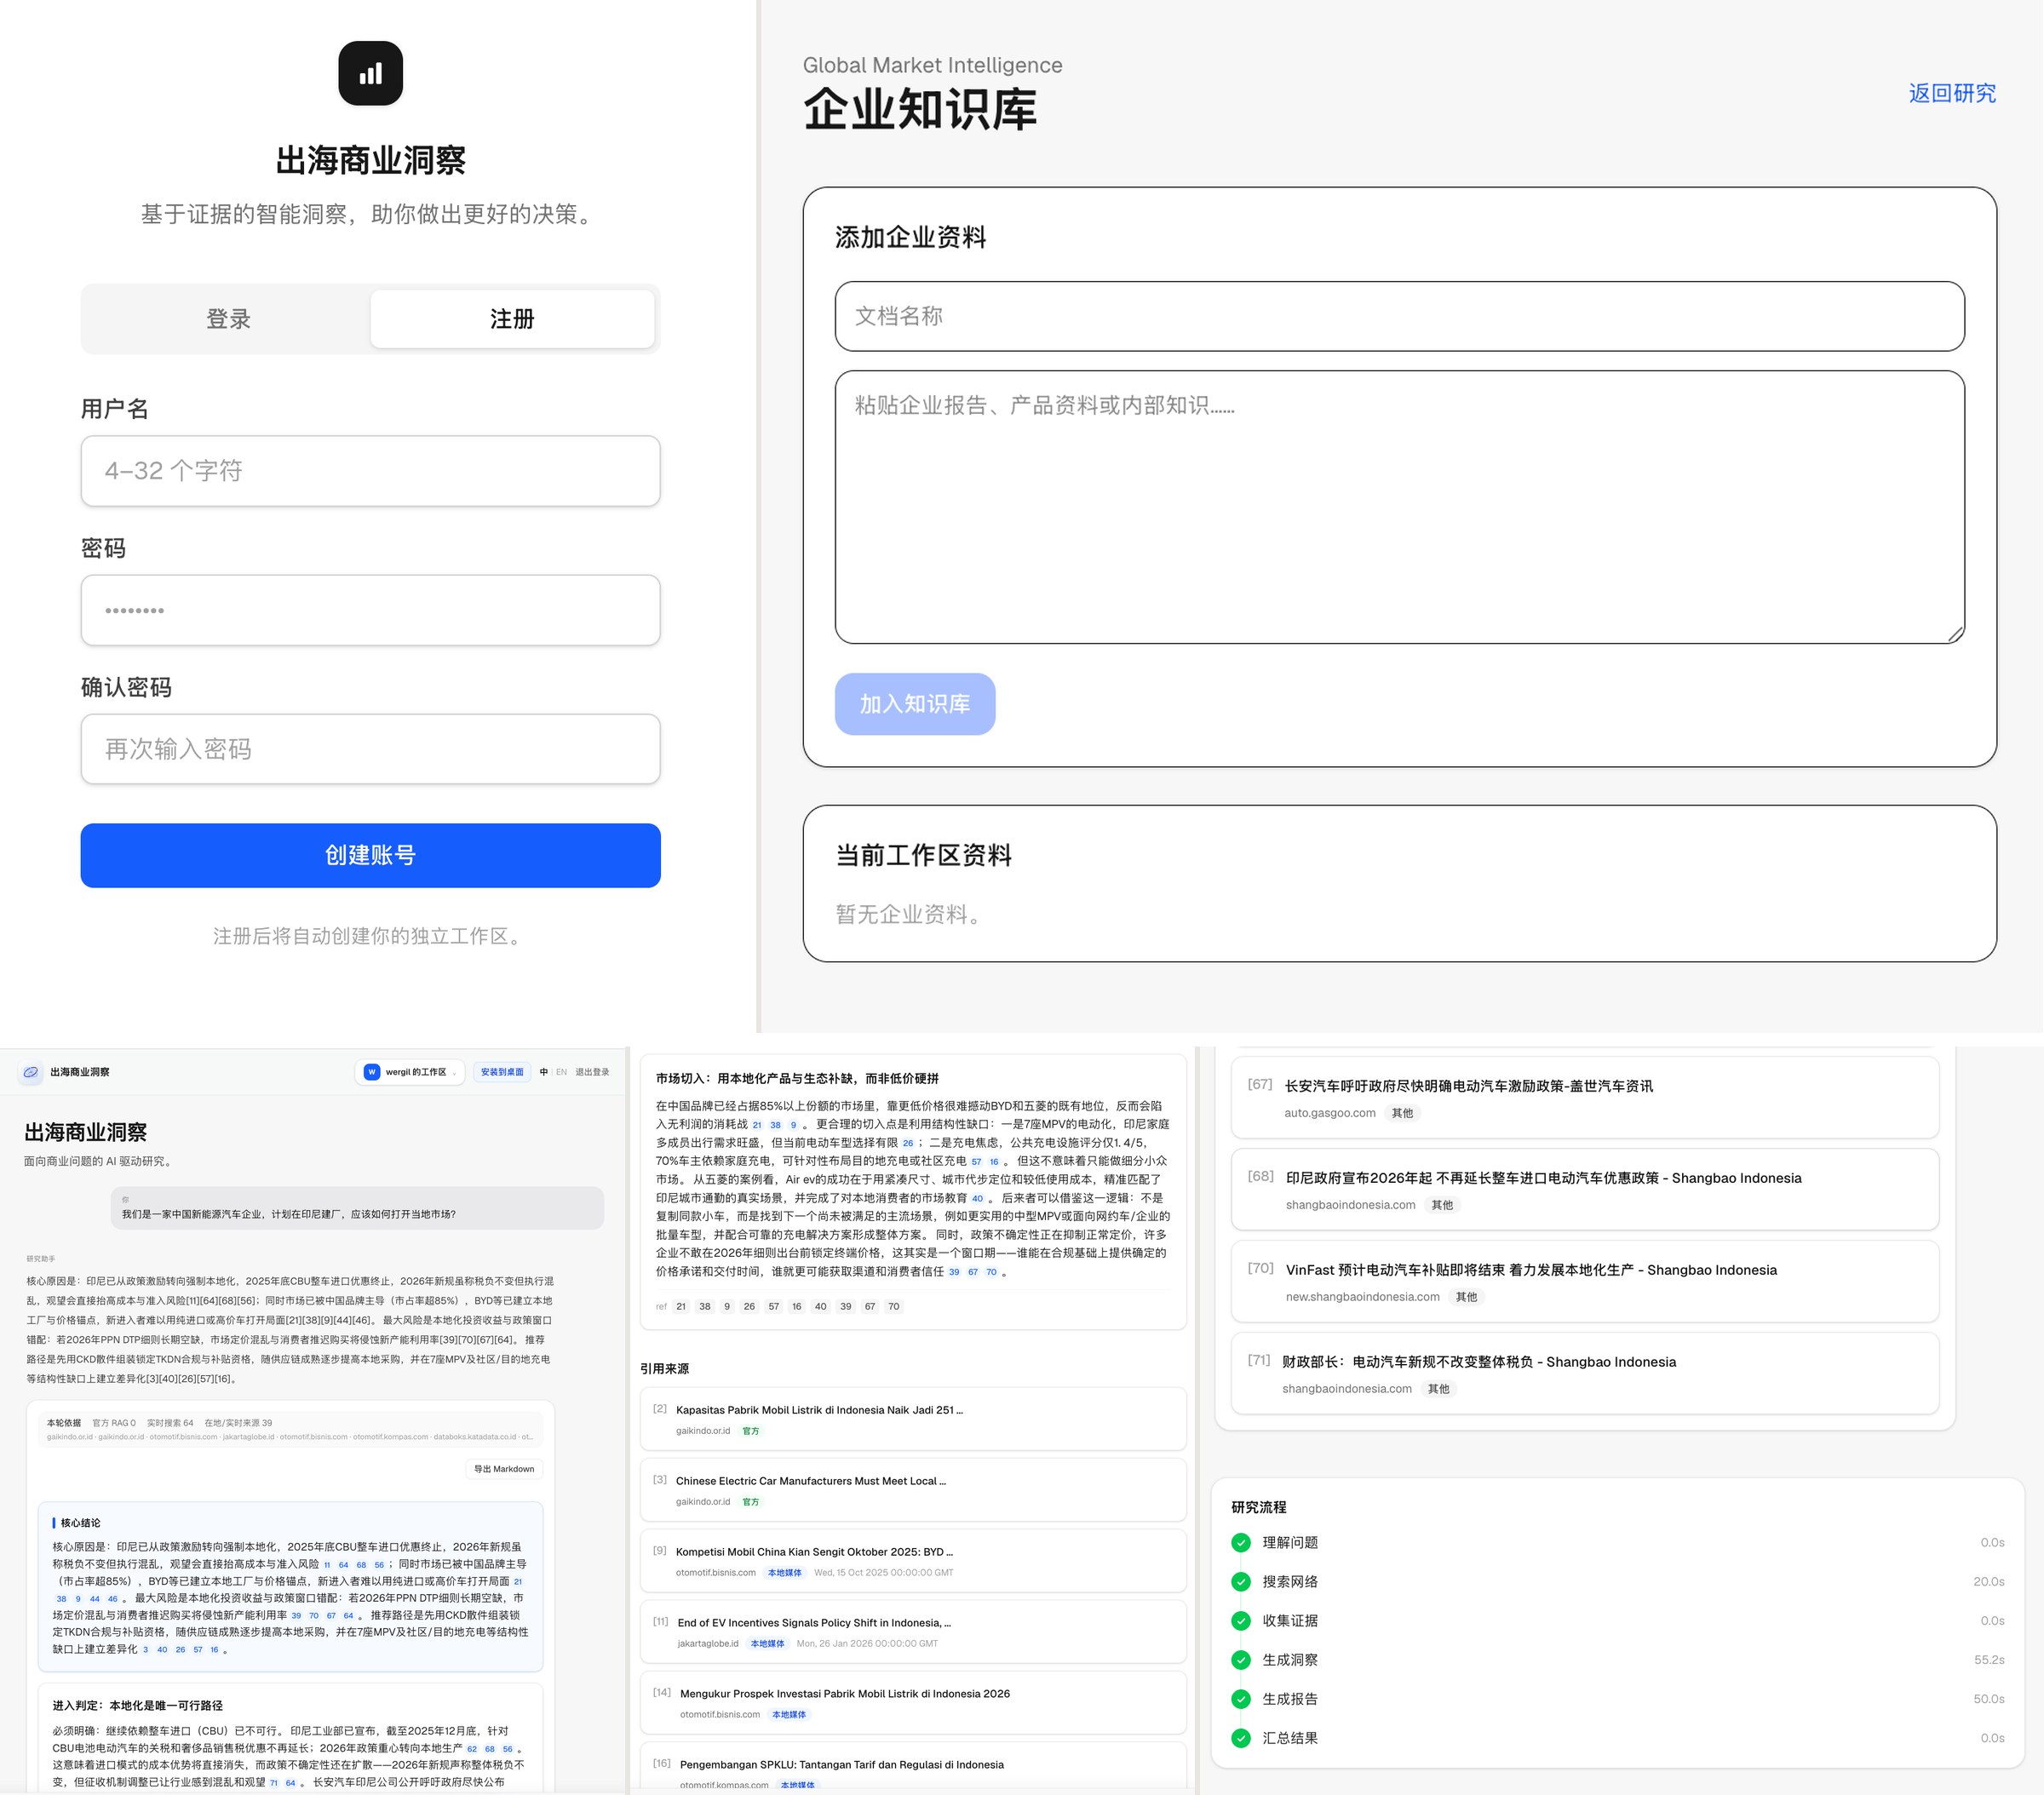
01 / 问题从哪里来
我在印度尼西亚做了六个月访问研究,也访谈了 30 多位出海企业负责人。大家经常提到三个问题。
第一,本地市场的信息不好找。很多关键政策、行业动态和企业信息只存在于当地政府网站或本地语言媒体里。
第二,跨国研究很容易串数据。一个看似合理的结论,背后的材料可能来自另一个市场。
第三,研究报告经常只有结论,没有证据链。对于真正要投入资金、团队和时间的企业来说,「听起来有道理」远远不够。
这三个问题最终决定了这个产品要优先解决什么——而不是我先选好了 Multi-Agent,再去寻找使用场景。
02 / 先定义什么叫「答得好」
在设计 Agent 之前,我先给产品定了四个验收指标。
- 国家匹配:讨论越南,就不能拿泰国或印尼的信息来填空。
- 证据支持:关键判断必须能回到具体来源;找不到证据就降低结论强度,而不是补一个听起来合理的答案。
- 来源质量:政府、官方机构、本地主流媒体和普通网页,不能被等权处理。
- 行动建议:研究最终要帮助企业做下一步决策,而不只是重新整理一遍公开资料。
后来的架构设计和评测体系,基本都围绕这四个指标展开。
03 / 把搜索、分析、写作和核验拆开
第一版产品最大的教训之一,是不能指望一次 Prompt 同时把检索、分析、写作和引用全部做好。 因此后续我把任务拆成几个责任不同的环节:
- Search Planner 决定应该查什么、用什么语言查、优先进入哪些来源;
- Insight 只处理已经进入 Evidence Store 的证据,并提炼其中的商业含义;
- Report 负责把分散洞察组织成完整报告;
- Critic 不参与写作,只检查国别混用、引用缺失和论据不足的问题。
Harness 负责整个流程的上下文、搜索预算和质量门禁。
与此同时,我搭建了覆盖 195 个国家的 Market Pack,共整理 2,367 个分层信源—— 其中包括 1,265 个官方来源和 1,102 个本地媒体来源。 对于相对稳定的基础信息,我另外整理了 311 份官方资料并切分为 22,949 个 Chunks,通过 RAG 提供补充。
Top-K 最终采用 K=8,也不是因为「行业一般这么做」,而是在人工标注测试集上比较不同参数后确定的。
04 / 怎么判断它真的变好了
我把评测分成两部分。一部分适合代码判断——有没有引用、引用是否存在、回答里是否混入错误国家的信息, 这些问题不存在「审美差异」,直接写成硬门禁; 另一部分很难用规则判断——分析是否完整、建议有没有可执行性、证据是否真正支持结论,交给 LLM-as-Judge。
我保留了 10 道回归题,同时增加 5 道泛化题:每轮迭代既检查旧问题有没有复发,也观察修改有没有只对少数测试题有效。五轮之后:
- 综合评分从 2.94 提升到 3.33 / 4;
- Actionability 提升 25%;
- Citation Quality 提升 15%;
- 硬门禁通过率达到 100%。
对我来说,比总分上涨更重要的是:我开始知道每次产品修改究竟解决了哪一种错误。
05 / 我会重做什么
这个项目里最顽固的 Bad Case 是「跨国资料串味」。 早期我不断修改生成 Prompt,希望模型自己注意国家边界,但效果一直不稳定; 后来我才把这个问题从「生成能力问题」重新定义成「质量控制问题」,交给 Critic 和代码规则处理, 效果比继续修改 Prompt 稳定得多。如果重新做一次,我会更早建立这一层核验。