- MY ROLE / 我的角色
- 独立完成 · 产品 / 架构 / 评测 / 工程
- TYPE / 类型
- 个人项目 · 导购 Agent
- DURATION / 周期
- 2026.07 — 2026.08 · 两个月
- STACK / 技术栈
- Taro · React · Node.js · PostgreSQL
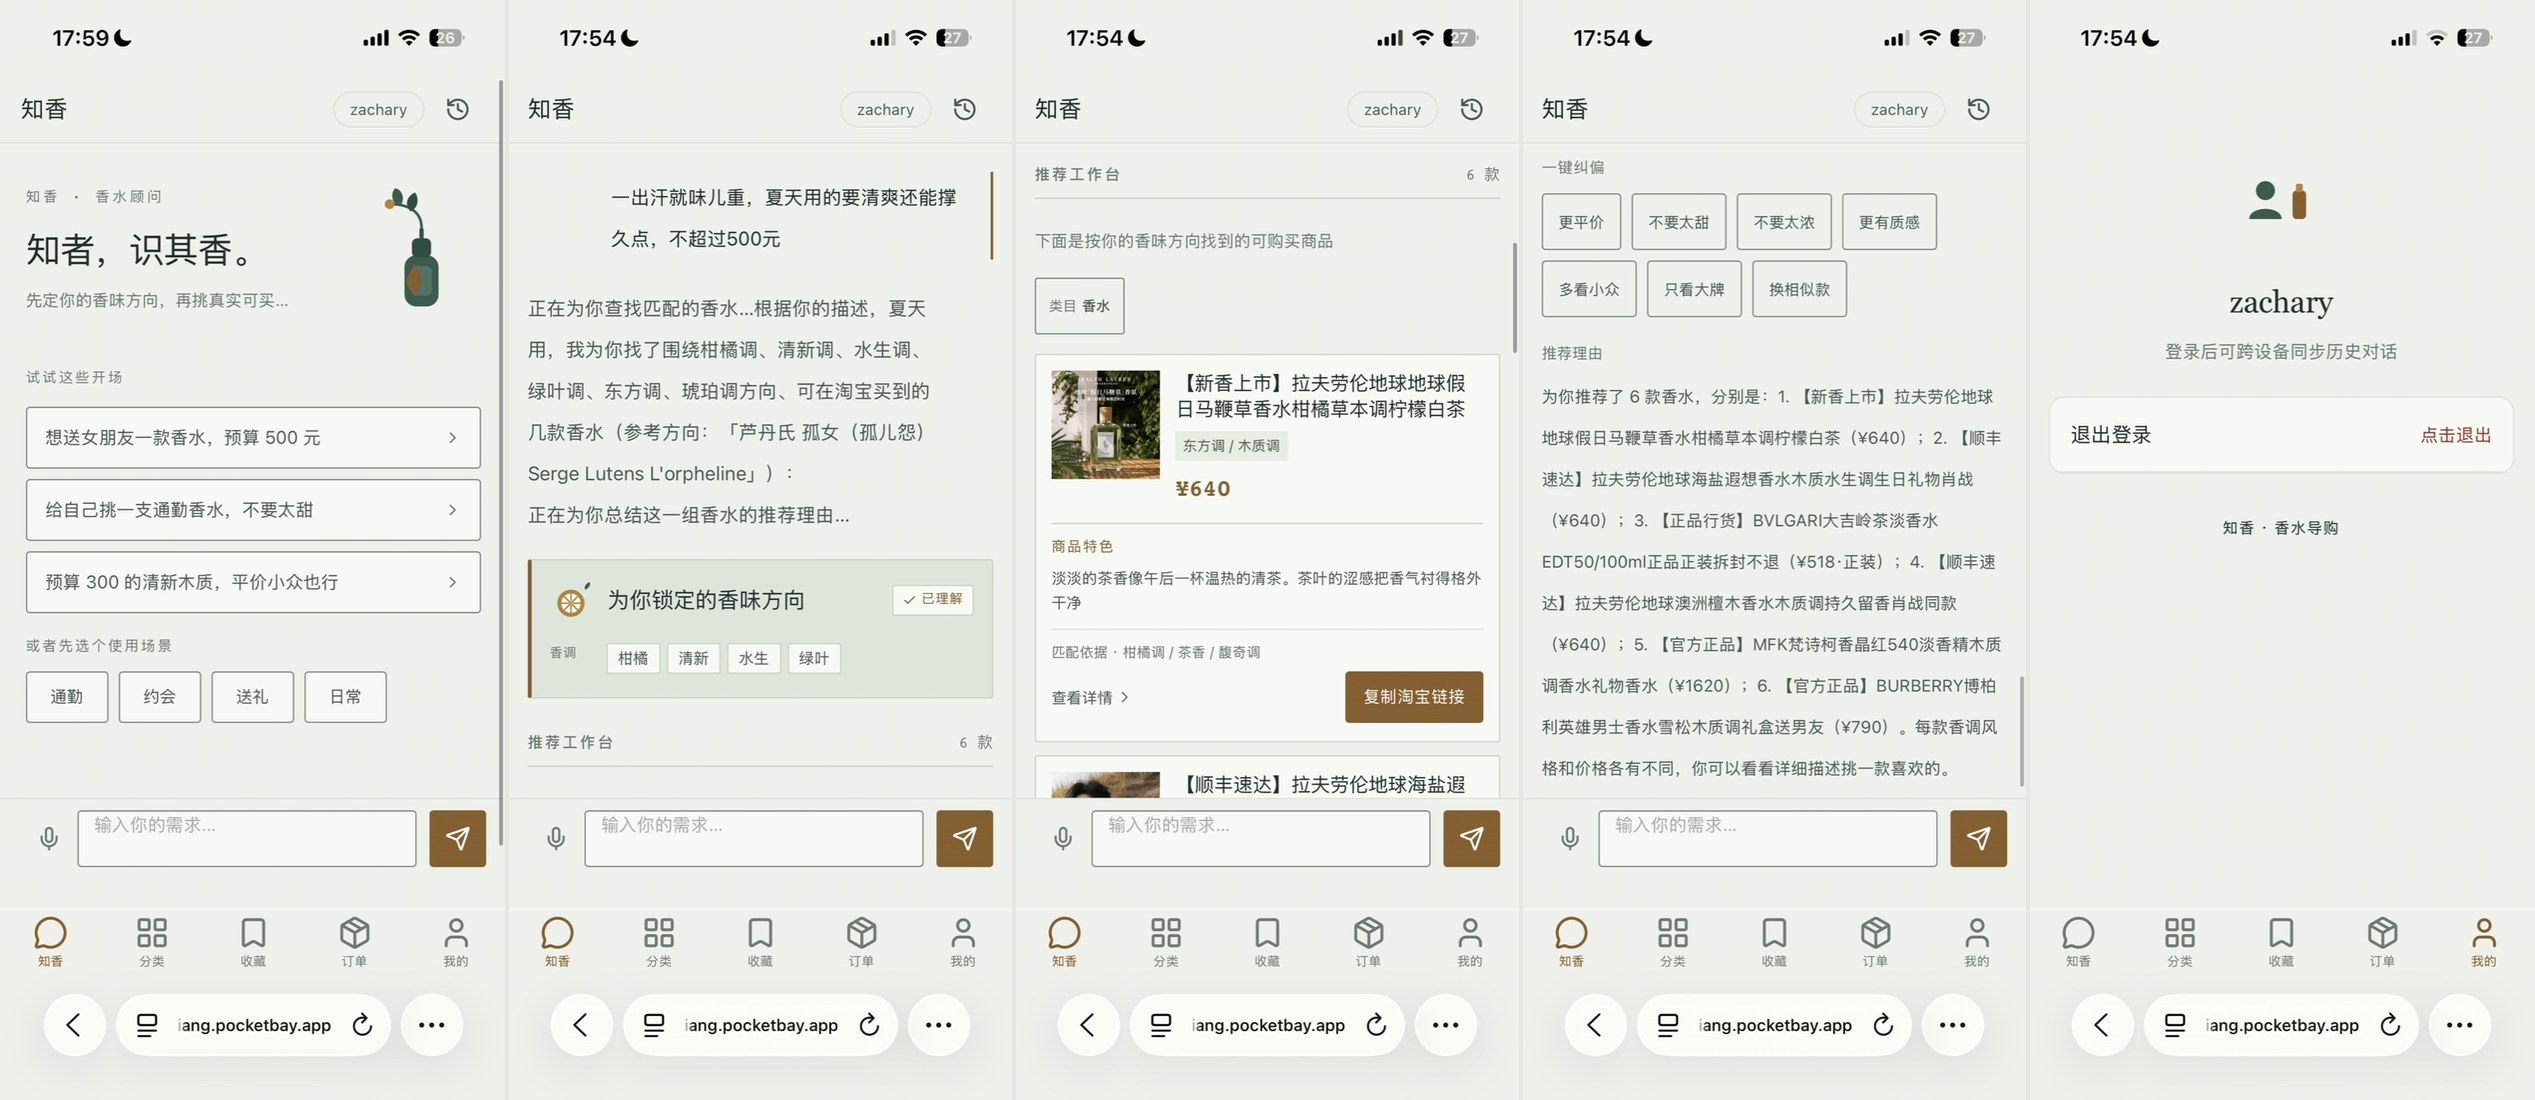
FIG.01 — 产品界面实录 · 自然语言找香 → 多轮澄清 → 真实商品推荐H5 · TARO + REACT
FIG.02 — 系统架构总览KG × REAL INVENTORY
+39%
三轮迭代后基础集综合评分 2.26/5 → 3.14/5
+35%
平均维度分 2.60/5 → 3.52/5
56 题
三套评测集:23 基础回归 + 23 改写外推 + 10 专项
1,971 款
香水知识图谱 · 覆盖 346 品牌 / 504 香原料 / 12 香调
01 / 我为什么做一个香水 Agent
和 20 多位消费者聊过以后,我发现新手买香水经常卡在三个地方:
他们很难准确描述自己喜欢什么;线上又闻不到;
即使平台推荐了一堆热门商品,也很难判断「为什么它适合我」。
这意味着普通搜索并不能完全解决问题。用户需要的不是更多 SKU,而是有人帮他把模糊偏好一步步缩小成几个可以选择的方向。
与此同时,大模型导购还有一个更现实的问题:它会推荐不存在、已经下架或者根本没有库存的商品。
在交易场景里,一次这样的推荐就足以让用户不再相信后面的答案。
02 / 模型不负责所有事情
我最后把系统拆成了三个部分。
- LLM 负责理解用户。例如把「学生党、不甜、夏天用」解析成场景、价格、气味偏好等结构化条件,并决定什么时候需要继续追问;
- 知识图谱负责香水知识。我整理了 1,971 款香水、346 个品牌、504 种香原料和 12 类香调之间的关系,让系统可以从用户描述继续找到具体香气方向和候选香水;
- 商品源负责回答「现在能不能买」。推荐结果最终必须回到拼多多或淘宝联盟的真实商品数据中——商品不存在,就不能生成一张看起来很完整的推荐卡片。
LLM 负责理解用户,知识图谱负责香水知识,商品源负责「现在能不能买」。
这不是为了让架构更复杂,而是因为这三个问题的可靠性要求完全不同。
03 / 为什么设计四级召回
真实商品池永远不会刚好包含最理想的答案。如果用户要求「300 元以内、木质调、适合女生、夏天、不甜」,
严格满足所有条件的商品可能一个都没有。这里有两个选择:要么告诉用户「没有结果」;
要么偷偷放宽条件,但不告诉用户。我都不太满意。
因此最后做成四级召回:
精准匹配 → 香调方向匹配 → 性别与场景兜底 → 品类兜底
随着条件逐级放宽,产品可以继续给出备选,同时保留「为什么这个结果只是次优选择」的解释。
宁可推荐一个明确说明取舍的相近商品,也不让模型虚构一个完美答案。
04 / 推荐好不好,怎么测
第一版做完以后,我很快发现「自己觉得推荐还不错」几乎没有意义。于是把真实失败案例整理成三套评测集:
- 23 题基础回归集,覆盖最常见的找香需求;
- 23 题改写外推集,把同一个需求换成更口语、更模糊的说法;
- 10 题 Bad Case 专项集,集中测试已经出现过的香调理解错误。
代码负责检查商品真实性等确定性问题,LLM-as-Judge 再评价偏好匹配、推荐解释和对话质量。
三轮迭代后:基础集综合评分从 2.26/5 提升到 3.14/5(+39%),
平均维度分从 2.60/5 提升到 3.52/5(+35%)。
比数字更有价值的是,评测让我能区分「模型没听懂用户」和「听懂了但商品池没有合适供给」
这两类完全不同的问题——它们需要的是两种不同的产品解法。
05 / 下一步最想补的东西
现在的系统已经能保证推荐商品真实存在,但「有商品」不等于「现在值得买」。
价格是否异常、库存是否稳定、不同平台有没有更好的规格,这些都是交易发生前最后一步的信息。
如果继续做,我最优先补的是实时价格与库存能力,而不是增加更多对话功能。
一个导购 Agent,最后还是要对「买得到、买得值不值」负责。